

 图: 李凯博士在CNCC2026“端侧存算一体芯片思辨论坛”现场演讲
10月23日下午,第23届中国计算机大会(CNCC 2026)“端侧智能的算力破局:存算一体芯片的量产之路与终端生态”思辨论坛在成都天府国际会议中心举行。本次论坛汇聚了端侧存算一体芯片产学研用各界——OPPO等终端厂商,复旦大学、北京大学、上海交通大学等高校团队,以及亿铸科技、光羽芯辰、微纳核芯等存算一体芯片企业同台,从芯片、整机到应用完整覆盖端侧产业链,共同探讨从流片走向规模化落地的关键路径。
论坛期间,深圳市迈特芯科技有限公司(以下简称:迈特芯)李凯博士带来了一场题为《张量脉动,四级跃迁——迈特芯端侧大模型芯片的破局实践》的演讲分享。
李凯博士分享了迈特芯为端侧大模型部署打造的 LPU(LLM Processing Unit)路线图。他指出,端侧大模型芯片正被(低功耗×低成本×高性能)不可能三角、内存墙以及场景适配三座大山同时卡住。真正需要的不是更大算力,而是更高效的端侧计算架构。迈特芯给出的答案是:张量脉动架构(TPU) + 并行3D-IO设计。
李凯博士在演讲中指出,端侧词元推理循环需要的是大带宽而非大算力——端侧AIPC需要约600GB/s带宽。在同等带宽条件下,2D LPDDR5X方案总功耗高达33.6–45.6W,而3D-PIM方案仅需3.8–7.2W。
更关键的是带宽利用率。李凯博士算了一笔账:行业大多数工作点带宽利用率只10%–30%、功耗约10-30W;迈特芯把目标工作点定在带宽利用率≥80%、功耗6-10W。他特别提醒,目前主流3D芯片厂商实测数据表明1W功耗约实现10tps性能,而所谓“300tps@1W”的需求是不可能的。
迈特芯的优势在于,并行3D-IO及TPU架构,对标国外顶级TPU IP的80%利用率,让智能体从语言、多模态到具身,在端侧完成闭环。
以下是演讲整理:
一、端侧大模型的三座大山
大家下午好。我来自深圳市迈特芯科技有限公司,今天主要分享迈特芯在端侧大模型芯片上的破局实践。
先看端侧为什么难。端侧大模型要上端侧,同时被三座大山卡住:
1.成本×功耗×性能的“不可能三角”:端侧要求低成本(<1000 RMB)、低功耗(~5W)、高性能(>100 tps),三者相互制约、难以兼得。
2.内存墙:算力提升不等于推理提速,数据搬运本身才是端侧推理的关键性能与能效瓶颈。
3.场景适配:通用方案深度优化不够,专用芯片又受场景空间限制,“通用不够深,专用不够广”。
我们的判断是:行业需要的不是更大算力,而是更优的端侧计算架构。迈特芯选择的路径是3D分布式TPU。
二、2D撞上内存墙,3D词元循环成为唯一解
李凯博士把云边端的算力需求画成了一张“分层词元循环”图:
1. 云端OPC 级—— 词元推理机:700B 模型 / 500TOPS / 500W / 500GB / 4.8TBps,对应服务器集群。
2.边侧企业级——词元推理卡:70B模型 / 50TOPS / 50W / 50GB / 1.2TBps,对应PC。
3.端侧家庭级——词元推理芯:7B模型 / 5TOPS / 5W / 5GB / 600GBps,对应平板、盒子、手机、机器人。
他特别引用了黄仁勋近期对端侧推理的评论:端侧AI 需要600GB/s带宽。
那600GB/s带宽怎么来?2D-lpddr和3D-PIM(近存LPU)的功耗成本对比非常直观:
1.2D LPDDR5X-9600:能耗比7.0–9.5 pJ/bit ,总功耗33.6–45.6W ,需布512-bit总线+32通道内存,PHY延迟约20–40ns。
2.3D-PIM:能耗比0.8–1.5 pJ/bit ,总功耗仅3.8–7.2W ,垂直堆叠在SoC/Logic之上,互连延迟<5ns。
目前旗舰手机采用4通道LPDDR5X、约76.8GB/s带宽。要做到600GB/s,2D路线在端侧功耗上已经走不通,3D路线是端侧大模型芯片的唯一解。
三、算清功耗账:80%带宽利用率才是3W的生死线
同样的带宽与算力预算下,决定端侧功耗的不是峰值性能,而是带宽利用率。
李凯博士现场算了三笔账:
1.4×工作点(高性能):峰值带宽800GB/s,320 tps,功耗32W;
2.1×工作点(基准):峰值带宽200GB/s,80 tps,功耗8W;
3.0.375×工作点(低功耗):峰值带宽75GB/s,30 tps,功耗3W。
在固定30 tps目标下,只有带宽利用率≥80%才能守住3W功耗预算:75GB/s ×80%利用率 = 60GB/s,对应3.0W。行业大多数工作点带宽利用率只有10%–30%,功耗约10-30W;迈特芯的目标工作点是带宽利用率≥80%、功耗6-10W。
四、破局双引擎:统一底座 × 3D近存计算
从三座大山到破局,迈特芯押注双引擎:
1.统一底座,解决“算什么”:一套数据流同时支撑语言、多模态与具身等各类大模型任务。
2.3D近存计算,解决“数据怎么喂”:热专家常驻3D DRAM,冷专家在NVMe SSD冷存池;弹性专家缓冲3D DRAM乒乓双缓冲,预测预取、回流冷存池。
这套架构让35B级稀疏模型(35B-A3B)真正做到“装得下、跑得动、用得起”,端侧稀疏MoE推理实测20–40 tps。
五、核心技术:3D-DRAM垂直封装与3D分布式IO
第一,3D-DRAM垂直封装,带宽从哪里来。迈特芯3D芯片总容量10GB、总功耗6W,采用全国产工艺,保障先进制程芯片的稳定量产与供应,摆脱对外依赖。
第二,3D分布式IO,数据不再绕远路。传统2D NoC架构里,数据被迫通过拥堵的中央总线横向传输,带宽利用率只有10%–30%。迈特芯用3D IO垂直直连每一个PE,配合“立方脉动计算”,数据在时钟周期内在3D网格中持续流动,实现持续80%的极高带宽利用率。
第三,具身推理的大小脑分工。“大脑” 负责任务理解与环境感知;“小脑” 负责动作生成与控制,实现高频率的实时响应。
第四,完整工具链。一站式打通从模型到端侧芯片的部署全链路,让大模型真正落到行动。
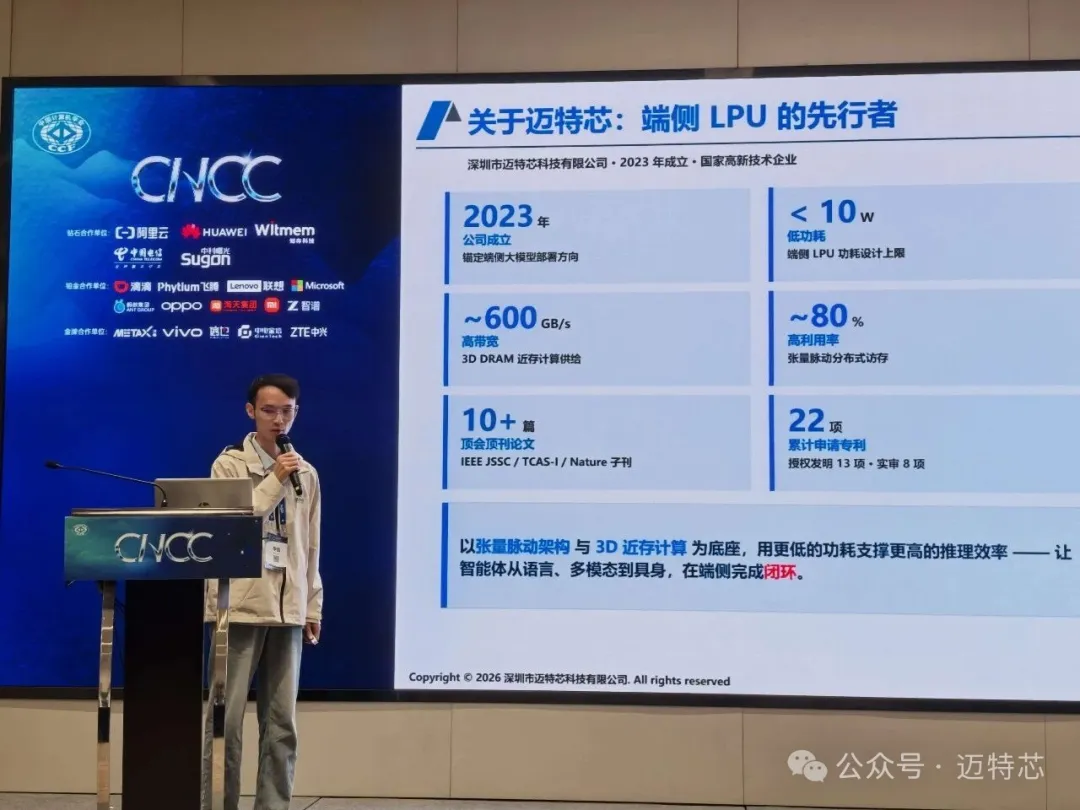
图:李凯博士介绍“关于迈特芯:端侧LPU的先行者”
六、流片进展:2D已点亮,3D走向量产
李凯博士现场晒了迈特芯的流片时间线:2023年2D-TPU IP验证 → 2024年3D-TPU FPGA验证 → 2025年3D-TPU ASIC验证 → 2026年2月3D-TPU正式流片 → 2026年8–11月样品交付 → 2027年ES验证转量产准备。
1.088芯片(2D方案):已成功点亮,跑通语音模型,整体架构验证完毕,目标百万到千万片量级市场,主打语音解决方案。
2.188芯片(3D方案):定位“国产大模型算力巅峰”,适配2B/4B/9B模型,平均功耗6W,推理速度80 tps。逻辑芯片本月底制造完毕,预计11月初获取封装芯片。
“点亮不是简单封在一起,而是模型真正跑起来,有数据、有性能。”李凯博士说。
七、四级跃迁:从EdgeLLM到EdgeVLA
同一副硬件底座,能力逐级放大——这就是演讲标题里的“四级跃迁”:
1.EdgeLLM 端侧语言推理:Qwen 7B,75 tps,吞吐较A100 1.67×,能效较A100 7.4×。
2.Edge-MLA/MoE 稀疏大模型:Qwen 30B / 35B-A3B,20–40 tps,解码较A100峰值加速2.94×。
3. EdgeVLM 多模态视觉语言:支持动态精度切换,推理速度与能效较行业标杆大幅提升。
4. EdgeVLA 具身动作生成:实现高频控制与高带宽利用率,任务成功率从 50%提升到 70%。
模型规模从3B到35B,模态从文本到视觉再到机器人动作闭环;矩阵运算占比超95%的同构负载,让同一底座可以逐级放大能力边界。
八、对标Muse的迈特芯个人智能体盒子
李凯博士最后把视野拉到个人智能体。迈特芯的商业化是对标Muse,以自研芯片构筑端侧AI基础设施(edge infra):L1个人交互终端用迈特芯088语音芯片做低功耗入口(智能眼镜、手机、随身终端、语音穿戴),中间层L2通过迈特芯188大模型芯片,结合迈特芯个人智能体 + 本地向量存储 + 安全隔离防火墙,实现应用层L3接入智能家居、机器人/机器狗与云端模型。
底座之选是迈特芯个人智能体盒子:算力隐私本地处理核心记忆与隐私逻辑,188芯片 + 迈特芯个人智能体盒子构建硬件护城河,端云协同做本地闭环、复杂推理调云端降Token成本。
迈特芯及南科大团队已在Nature子刊、IEEE JSSC、TCAS-I、OJSSCS、DAC、FPGA Symp、FPT等顶刊顶会发表论文10余篇,累计申请专利22项(授权发明13项),形成“架构→编译→芯片→场景”全链条专利布局。其中EdgeLLM(IEEE TCAS-I)工作是目前该领域高被引文章。公司商务也与众多计算、通信、终端及具身龙头企业推动商业化落地。
最后做一句总结:迈特芯希望以张量脉动架构与3D近存计算为底座,让智能体从语言、多模态到具身,在端侧完成闭环。

